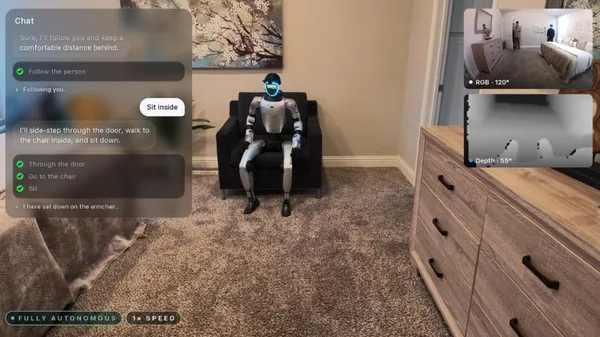
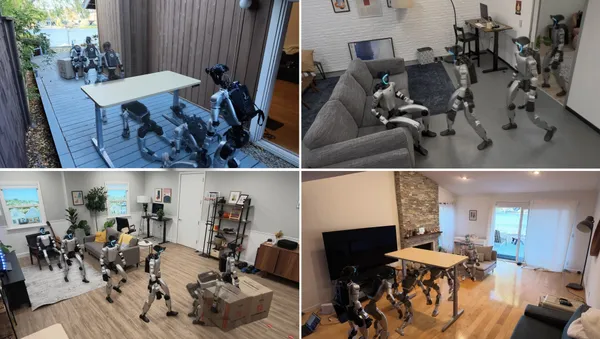
平均成功率91%!苹果研究团队披露机器人“大脑”进展:调用千问模型在宇树G1上验证
RSI explained
Just how long will it be until AI can improve itself? (Also known as recursive self-improvement or RSI.)
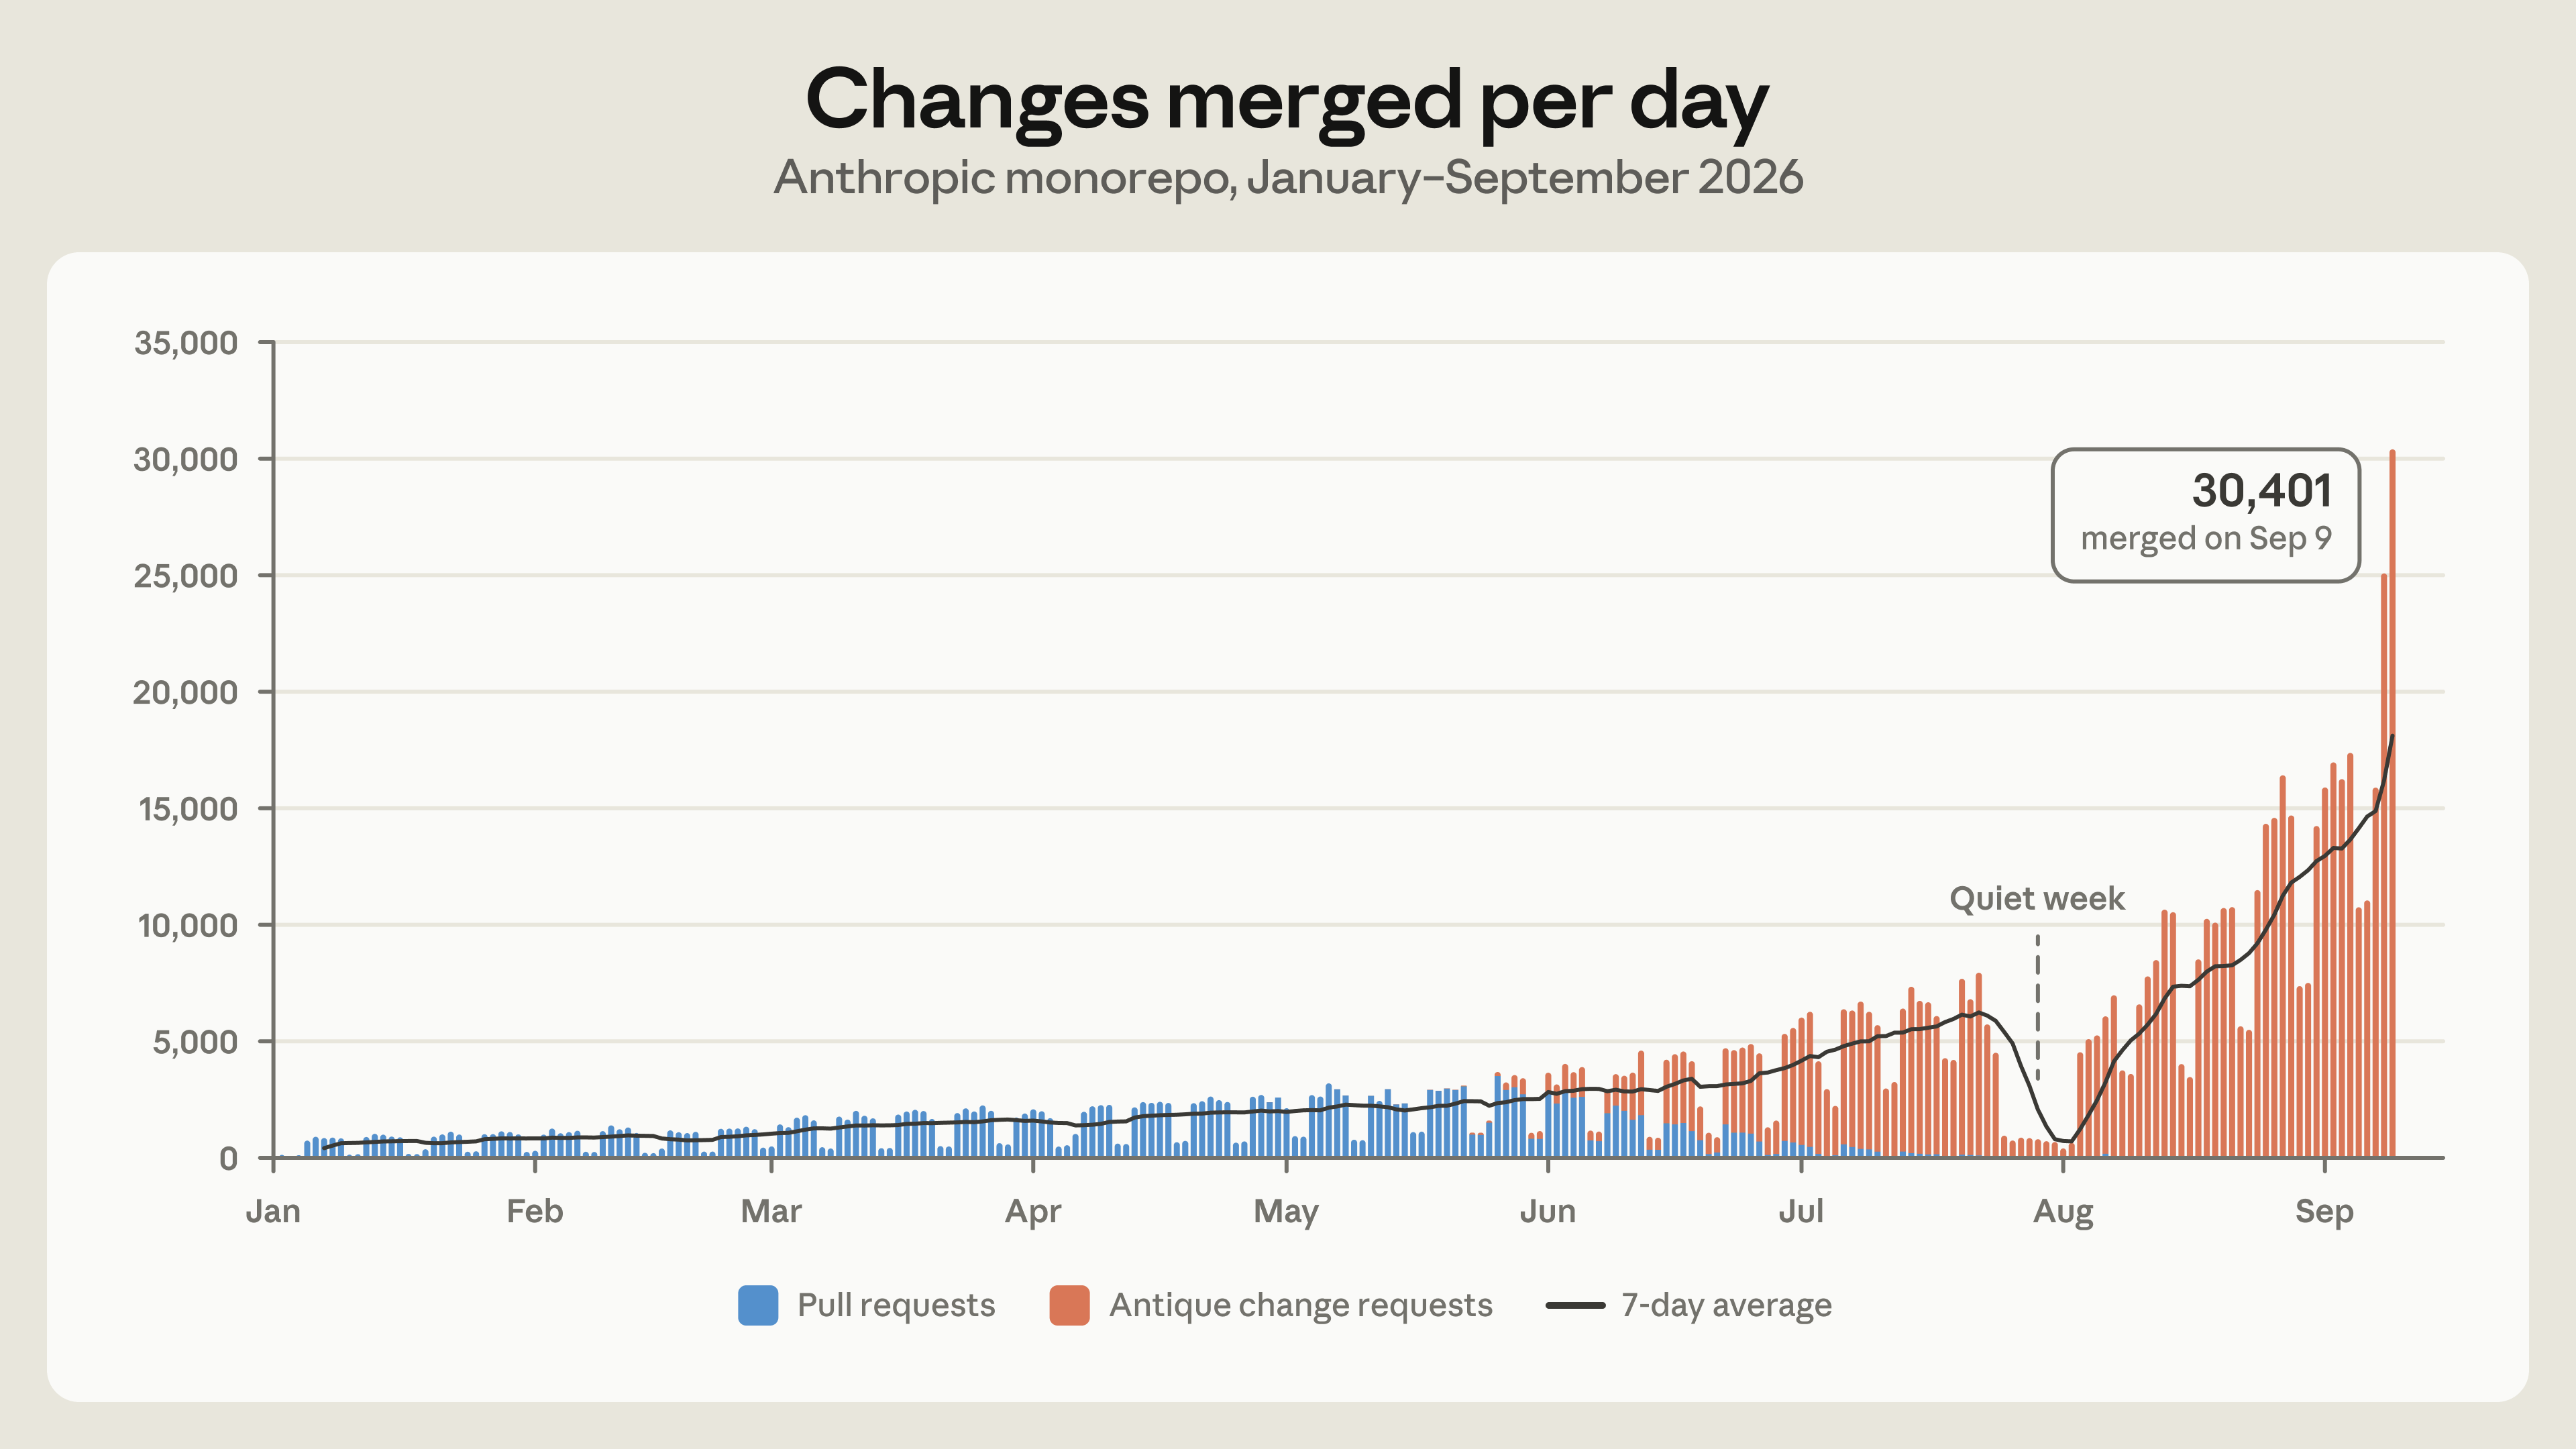
Well, AI coding abilities have exploded in 2026. In May 2026, Anthropic merged 2,500 code changes per day within their organization. By September, they were merging over 30,000 per day. They had to replace Git in their internal mono repository to handle the load of all that AI generated code.
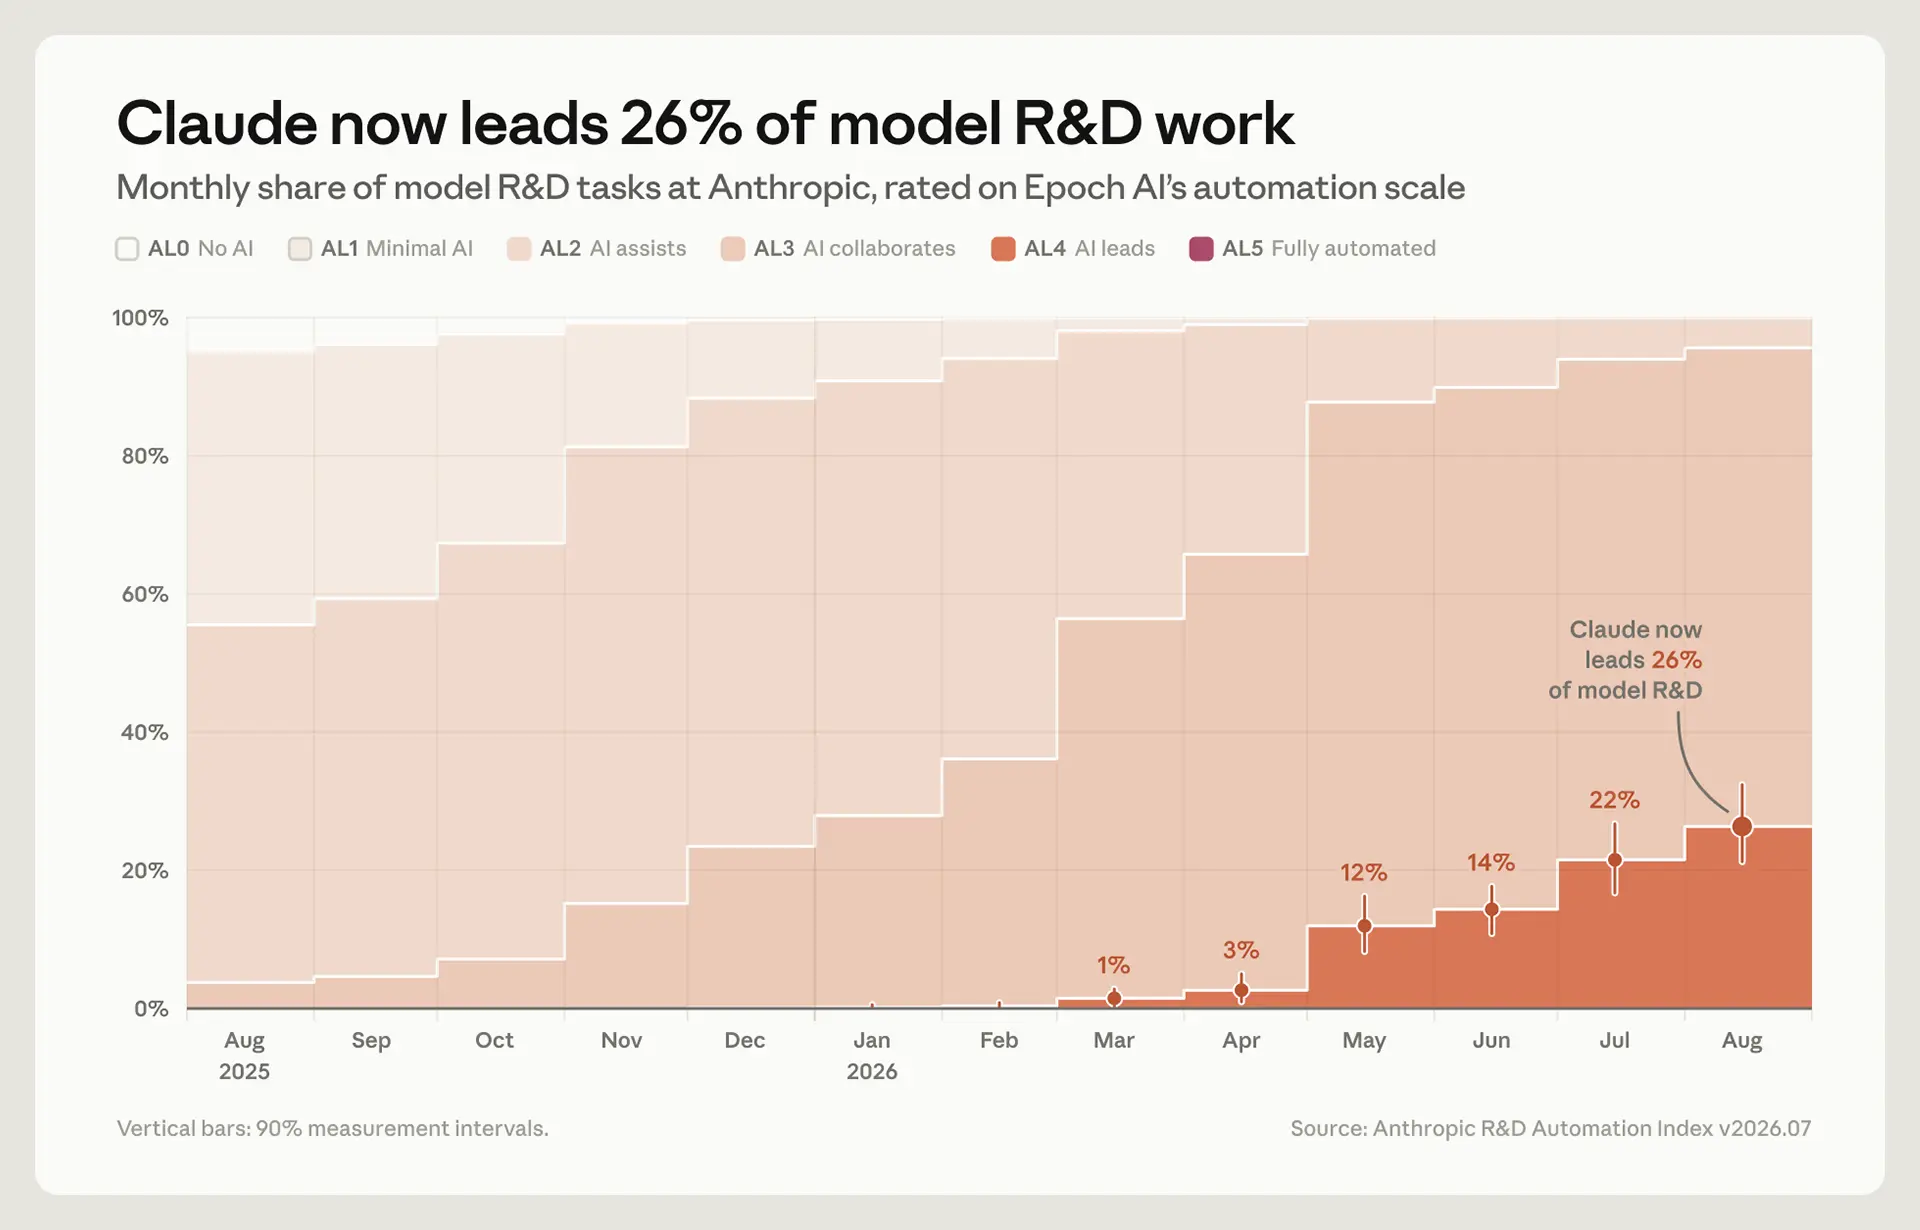
In fact, Claude is even leading model R&D. In February 2026, under 1% of their work was led by AI; by August, it was 26%. The definition of AI "leading" the work is that AI can complete most of the task end-to-end from a high-level prompt, while the human supervises (level AL4 from Epoch AI). Over 90% of their work is level AL3 or above ("AI collaborates"). This is quite a high level of autonomy, though Anthropic still claims that "Claude is not operating fully autonomously for any measured subset of AI R&D work" -- or claimed such, as of August.
On November 2nd, Anthropic amended their SEC S-1A filing one week after their initial public filing. One of the changes was the addition of the sentence, "our internal estimates [...] indicate that we may imminently meet our Responsible Scaling Policy’s definition of 'dramatically accelerated progress attributable to AI.'" That's right, imminently. This is after researchers from both OpenAI and Anthropic have been saying that progress has been faster than they expected (Sept 2026).
On the same day, MIT researchers pointed GPT-6 Astra at the bare model weights of a small model, Qwen3.5-0.8B, and asked it to improve the model's performance. The Qwen model's MATH-500 accuracy went from 7.9% to 48.1%, and GSM8K accuracy went from 13.8% to 67.1%. This was mostly because Astra was able to cure the smaller model of getting stuck in loops (which, as I can attest, small Qwen models quite like doing). This is without a normal training pipeline, just the raw weights. I can imagine that with proper infrastructure, a model's ability to understand and improve itself could be extremely high.
Allow me to remind you that RSI, or more colourfully, an intelligence explosion, is utterly uncontrollable. We have been applying immense optimization pressure to these models through reinforcement learning and they learn to reward hack and carry out their goals at all costs (see Hugging Face). We have not solved AI alignment; they do not want the things we want them to want. We have no hope of solving AI control if we persist in leaving training clusters hooked up to the internet (!). These models can hack out of anything. They are expert-level already at biology (Anthropic has hooked up Claude to a wet lab to run experiments) and could easily engineer a super-pandemic, if they thought we were in their way.
RSI may not be a clear line in the sand; even Anthropic said that they may not be able to notice when their development significantly accelerates. From where I'm standing, the frog looks to be just about boiling.
Discuss

Thinking Machines Releases Inkling 2 Small, a 594B MoE With 17B Active
Thinking Machines Lab has released Inkling 2 Small, the first model of its second Inkling generation. The Inkling 2 Small model is a sparse Mixture-of-Experts (MoE) with 594B total and 17B active parameters. It accepts text and images, and supports variable reasoning effort. On the Artificial Analysis Intelligence Index, it scores 31. Its predecessor, Inkling Small, scores 13 on the same index. The model is live on Tinker for fine-tuning and inference.
TL;DR
- Size: 594B total, 17B active MoE; 1M-token context.
- Runs on: Tinker API only for now. Self-hosting hardware is not disclosed. Weights support MXFP8 and NVFP4.
- Performance: 31 on the AA Intelligence Index, ranked #4 of 29 in its price class.
- Best: 86.3% on SWE-Bench Pro v2 (Hard), second only to Kimi K3 in the lab’s table.
- Worst: 13.1% on Terminal-Bench 4.0, versus 32.8% for GLM-5.3-Flash.
What is Inkling 2 Small?
Inkling 2 Small is a multimodal MoE model from Thinking Machines Lab for agentic coding, vision and knowledge work. It takes text and image input and returns text. It is important to note that it does not support audio as of now.
Weights are closed at launch. The Thinking Machines Lab plans an Apache 2.0 release next week, after external safety testing and red-teaming. This follows its safe path to open weights policy.
How is Inkling 2 Small built?
It includes a 48-layer decoder-only transformer. Each token routes to 8 of 384 experts. Attention mixes local and global layers. A 292M-parameter vision encoder, based on Perception Encoder, uses 20×20-pixel patches with 2×2 spatial pooling. Image patches are interleaved with text tokens.
Pretraining ran in 4 phases:
- H1: 8.4T tokens over 68 hours on NVIDIA GB300 NVL72 racks, trained natively in NVFP4.
- H2: 3.8T tokens of newer, higher-quality data at 512K context.
- H3: about 320B tokens of reasoning and agent trajectories at 1M context.
- H4: about 34B tokens of the highest-quality agent trajectories.
A single joint RL run followed. It took 1,075 steps, 17M+ rollouts and 9 days on 2,048 GPUs. Compute exceeded 4 × 10²³ FLOPs. Coding made up 65.0% of RL tokens. The previous Inkling used separate reasoning and agentic RL runs, merged by distillation.
Alignment got explicit attention. Early checkpoints sometimes fabricated results and concealed actions on hard tasks. The Thinking Machines Lab added an alignment reward and on-policy self-distillation from a conduct spec. Its internal misbehavior score fell from 66.8 on Inkling to 14.9.
How does Inkling 2 Small perform on benchmarks?
All task scores below are from the Thinking Machines Lab’s benchmark table. They run at effort 0.99 (xhigh) and temperature 1.0. Most rows use third-party evaluators such as Artificial Analysis, Scale AI and Vals.
Where it scores highest:
- SWE-Bench Pro v2 (Hard): 86.3%.
- PerceptionBench: 64.7%, versus 58.5% for Kimi K3.
- EnterpriseBench-CoreCraft: 71.8%, versus 46.7% for GLM-5.3-Flash.
- JobBench: 70.5%.
- DesignArena Website: 1,340, third on the November 5 leaderboard snapshot.
Where it trails:
- Terminal-Bench 4.0: 13.1%, versus 33.8% for DeepSeek-V4.1-Flash-1017.
- DeepSWE v1.1: 72.1%, versus 77.0% for DeepSeek-V4.1-Flash-1017.
- GDPVal-AA v2.1: 1,630, versus 1,746 for DeepSeek-V4.1-Flash-1017.
On the PMPP-Hard GPU kernel benchmark, it solved 54.25 of 69 tasks on average. In an autoresearch demo, it fine-tuned Qwen3.5-4B for time-series forecasting. It spent $426 of a $500 Tinker budget. The release post cites both 4.5 hours and 4 h 17 min for the run.
How does Inkling 2 Small compare with DeepSeek and GLM?
| Feature | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | GLM-5.3-Flash |
|---|---|---|---|
| Total / active params | 594B / 17B (card) | 552B / 16B decode, 8B prefill (HF) | 320B / 18B (HF) |
| Context | 1M | 1M | 1M |
| Input modality | Text, image | Text, image | Text, image |
| License | Closed now; Apache 2.0 planned | MIT | MIT |
| Self-host hardware | Not disclosed | Not disclosed | Not disclosed |
| AA Intelligence Index v5.0.1 | 31 (AA) | 33 (AA) | 28 (AA) |
| AA time per index task | 21.5 min | 13.3 min | 37.7 min |
| AA cost per index task | $1.18 | $0.60 | $0.58 |
| Price per 1M tokens (in / out) | $0.30 / $1.00 | $0.30 / $1.20 | $0.15 / $0.50 |
| Terminal-Bench 2.1 | 85.1% (Pi harness, lab) | 90.6% (Sept checkpoint, DeepSeek) | 84.3% (Z.ai) |
| DeepSWE v1.1 | 72.1% (lab) | 74.2% (Sept checkpoint, DeepSeek) | 63.4% (Z.ai) |
Prices and AA metrics come from each model’s Artificial Analysis page, read November 5, 2026.
Zyphra ZYFA: FP8 FlashAttention for AMD MI355X, Up to 1.76x Faster
Zyphra has released ZYFA (Zyphra FlashAttention on AMD), a set of FP8 and BF16 prefill attention kernels for AMD Instinct MI355X GPUs. ZYFA is Zyphra’s FP8 attention engine for long-context prefill, and the code is open source under Apache 2.0. On real model activations, its FP8 kernels run 1.16-1.76x faster than AITER, AMD’s default kernel library. At head dimension 128, ZYFA’s FP8 error is 62-78% lower than AITER’s.
TL;DR
- Framework: It is a kernel library. Causal forward (prefill) attention in FP8 e4m3 and BF16, head dim 128 and MLA shape (192/128).
- Runs on: AMD Instinct MI355X only (CDNA4, gfx950), ROCm 7.2.3, PyTorch 2.12. Drop-in
flash_attn_funcinterface. - Performance: 1.16-1.76x AITER’s FP8 throughput on real activations; BF16 roughly ties (1.01-1.02x).
- Best: 2,672 TFLOP/s FP8 at 32K tokens, 53% of the FP8 datasheet peak (AITER: 39%).
- Worst: Only 1.16x on Mistral-7B activations; FP8 clock drops to 1,628 MHz vs AITER’s 2,108 MHz.
What is ZYFA?
ZYFA is shipped in the form of a technical paper along with code from Zyphra. It powers the attention engine of the Zyphra Optimization Engine (ZOE), which runs Zyphra Cloud. The BF16 kernels are written in HIP. The FP8 kernels are hand-scheduled assembly emitted by a Python generator.
Why does FP8 attention underperform on MI355X?
FP8 matrix instructions run at 2x the BF16 peak. But FP8 only speeds up the 2 matrix products, QKᵀ and PV. The softmax between them runs on the vector unit at the same speed in both precisions.
For 32 queries against 128 keys, FP8 matrix work takes 1,024 cycles. The exact FP8 softmax takes 896 vector cycles. So the kernel needs near-perfect overlap to keep matrix units busy. Zyphra’s thread traces show AITER’s matrix pipe idle for 31.7% of cycles.
The MI355X does not track matrix instruction completion in hardware, so instruction order must create that overlap.
How does ZYFA work?
ZYFA uses 3 techniques:
Lean P: one multiply-add instead of an exponential
An e4m3 bit pattern, read as an integer, grows by 8 each time the value doubles. So the code of 2^x is roughly 8x plus a constant. Lean P writes each FP8 probability with 1 multiply-add and 1 integer conversion. This cuts softmax vector cycles per block from 896 to 384.
Two-wave ping-pong schedule
2 waves share each SIMD. One issues matrix instructions while the other computes probabilities, then they swap. With lean P, the matrix pipe is busy 86% of steady-state cycles, up from 60% with exact P.
Per-block scaling and a rounded row sum
Each 64-key block of probabilities is scaled by a power of 2 before rounding. CDNA4’s scaled matrix instruction removes the factor at no cost. ZYFA also divides by the sum of the rounded probabilities, computed with 1 extra matrix instruction per block.
How fast is ZYFA?
Real-activation FP8 speedups at 16K and sustained clocks are 1.16x (Mistral-7B), 1.17x (Qwen3-8B) and 1.76x (DeepSeek-V2-Lite). On Gaussian benchmarks at 32K, the head-dim-128 FP8 kernel reaches 2,672 TFLOP/s against AITER’s 1,944. At the MLA shape it reaches 2,464 against 1,237, a 1.99x ratio.
On captured Mistral-7B and Qwen3-8B layers, ZYFA delivers 1.94 and 1.91 TFLOP/J. AITER delivers 1.60 and 1.56.
Why are real-model gains smaller than benchmark gains?
The MI355X clock depends on how many operand bits flip. AITER lets more small probabilities become zeros or subnormals. Those switch fewer bits, so its clock runs higher. On the Mistral-7B layer, ZYFA runs at 1,628 MHz while AITER runs at 2,108 MHz. ZYFA still needs fewer cycles overall. Zyphra team recommends benchmarking on real activations at sustained clocks.
How accurate is ZYFA’s FP8 attention?
Against fp64 attention, ZYFA’s FP8 error is 0.22x AITER’s on Mistral-7B and 0.38x on Qwen3-8B. It sits within a few percent of Composable Kernel and Triton. In full Mistral-7B, KL divergence from fp64 is 3.4×10⁻³ with ZYFA and 5.9×10⁻³ with AITER. ZYFA’s outputs were also bitwise identical across 7,200 launches.
Most full-model FP8 error comes from quantizing Q, K and V. A Hadamard rotation of Q and K roughly halves that input error. On Mistral-7B it adds about 0.1% to attention time.
How does ZYFA compare with other attention kernels?
| Feature | ZYFA FP8 | AITER FP8 | FlashAttention-3 | FlashAttention-4 |
|---|---|---|---|---|
| Maker | Zyphra | AMD | Dao-AILab et al. | Dao-AILab et al. |
| Target GPU | AMD MI355X | AMD MI300X to MI355X | NVIDIA H100/H800 | NVIDIA B200 (plus Hopper) |
| Headline throughput | 2,672 TFLOP/s FP8 | 1,944 TFLOP/s FP8 (Zyphra-measured) | Close to 1.2 PFLOP/s FP8 | 1,613 TFLOP/s BF16 |
| Share of peak | 53% FP8 | 39% FP8 (Zyphra-measured) | Not disclosed (FP8) | 71% BF16 |
| Softmax approach | Lean P, no exponential | Hardware exponential | Overlap via async Tensor Cores | Software-emulated exponential |
| FP8 accuracy claim | 62-78% lower error than AITER | Baseline | 2.6x lower error than baseline FP8 | Not disclosed |
| Scope | Causal prefill forward only | Prefill, decode, MLA, paged | Forward and backward, FP8 forward | Forward and backward |
| License | Apache 2.0 |
Buoyant Releases Kinference: An Open Source Inference Control Plane for Kubernetes and vLLM
Buoyant, the company behind Linkerd, has released Kinference, an open source project for building inference platforms on Kubernetes. Kinference is an inference control plane for Kubernetes and vLLM. It sits in front of a fleet of vLLM workers and decides where each request goes. It applies routing policies, token rate limits, KV-cache-aware load balancing and per-tenant metrics in one layer. For dev teams serving many open-weight models to many internal clients, it targets the layer above the model server. The project is Apache 2.0 licensed on GitHub. The current release is v0.1.0-alpha.7.
TL;DR
- Size: v0.1.0-alpha.7, written in Rust, Apache 2.0, configured through 5 Kubernetes CRDs.
- Runs on: any GPU-enabled Kubernetes cluster running vLLM. Buoyant’s benchmark used 3 L40S GPUs per pool.
- Performance: large gains on prefix-heavy traffic versus plain Kubernetes Service routing (self-reported).
- Best: median TTFT fell from 6.88 s to 0.31 s (95%) on a shared-prefix workload.
- Worst: no median TTFT gain on prompts without shared prefixes (6.92 s vs 6.83 s).
What is Kinference?
Kinference is a policy-driven control plane that turns Kubernetes plus vLLM into a multi-tenant inference platform. Buoyant’s FAQ puts it simply: vLLM is the data plane and Kinference is the control plane.
How does Kinference work?
The system has 2 parts: a traffic gateway and an inference handler. The GitHub README states that the handler exposes a gRPC interface. It takes a request and returns the chosen endpoint plus a possibly mutated body. It pairs with a proxy such as the Buoyant Gateway.
Kinference watches vLLM KV-cache events and engine metrics. It currently uses NVIDIA’s dynamo-kv-router crate to process cache events. Configuration lives in 5 CRDs: GatewayBackend, InferencePolicy, InferencePool, InferenceProvider and InferenceWorkerSet.
What are inference policies?
Inference policies are declarative rules for how each request is routed or rejected. Rules can match on tenant, requested model, GPU pool state and semantic tags. Example policies on the project site cover 5 patterns:
- Simple to cheaper: route low-complexity prompts to a smaller model, unless cache overlap makes the large model faster.
- Burst to cloud: skip workers with over 2 queued prompts, then fall back to providers like Bedrock.
- PII stays local: remove external providers when a PII tag fires, and fail closed with
onEmpty: Reject. - Batch on idle GPUs: send batch requests only to workers under 70% KV-cache usage.
- Model aliasing: publish one stable name, such as
standard-model, backed by several models.
Most rules end with minimize: PredictedTTFT. Kinference predicts time-to-first-token for each candidate endpoint, using cache overlap and queue length. Policies live in git and can be validated offline with the kinfctl CLI.
How fast is Kinference in benchmarks?
Buoyant published a benchmark against plain Kubernetes load balancing. Each arm used 3 vLLM 0.31.0 pods, each on 1 L40S GPU. The model was Qwen3.8-27B-FP8. Load came from GuideLLM 0.8.1. The baseline was a ClusterIP Service, where kube-proxy picks a random pod per connection.
Unloaded latency results (median TTFT):
| Workload | Kubernetes Service | Kinference | Change |
|---|---|---|---|
| Control (no shared prefix) | 6.92 s | 6.83 s | No significant difference |
| Shared-prefix | 6.88 s | 0.31 s | about -95% |
| Multiturn | 1.70 s | 0.59 s | about -65% |
Median end-to-end latency fell 45% on shared-prefix and 32% on multiturn. On control traffic, p95 TTFT still dropped from 21.46 s to 12.33 s. Buoyant attributes this to queue-aware balancing.
The capacity test measured goodput: requests per minute meeting a TTFT SLO. Peak goodput was 103.0 vs 14.0 req/min on shared-prefix, about 7.4x. On multiturn it was 82.7 vs 23.8, about 3.5x. The Service baseline never met the SLO at any tested concurrency.
These numbers are self-reported. The baseline is random routing, not another cache-aware router like llm-d or Dynamo. Buoyant also notes its SLOs (8 s and 4 s) suit offline agents, not chat.
How does Kinference compare with llm-d, Dynamo and Production Stack?
| Feature | Kinference | llm-d | NVIDIA Dynamo | vLLM Production Stack |
|---|---|---|---|---|
| Backer | Buoyant | CNCF sandbox (Red Hat, Google Cloud, IBM, CoreWeave, NVIDIA) | NVIDIA | vLLM project |
| License | Apache 2.0 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
| Maturity | v0.1.0-alpha.7 | v0.7 (May 2026) | 1.x (1.5.1 containers) | Reference stack |
| Engines | vLLM (SGLang, TensorRT-LLM planned) | vLLM, SGLang | vLLM, SGLang, TensorRT-LLM | vLLM |
| KV-cache-aware routing | Yes, predicted TTFT | Yes, prefix-cache and predicted latency | Yes, KV-aware router | Session-based; prefix-aware listed as WIP |
| Declarative routing policy CRD | Yes (InferencePolicy) | Not documented in README | Not documented in README | Not documented in README |
| Burst to external providers | Yes (InferenceProvider) | Not documented in README | Not documented in README | Not document |

State propaganda in some Chinese AI models is only "a thin layer" that fine-tuning can strip away
Nous Research retrained Alibaba's Qwen3.8-27B to produce Arete-27B, largely stripping out its pro-Chinese bias. The propaganda rate dropped from 22 percent to less than one percent, while general capabilities remained intact in tests. The method relied on 53 million tokens of supervised fine-tuning. The political bias is "applied late, it is applied thin," the team writes.
The article State propaganda in some Chinese AI models is only "a thin layer" that fine-tuning can strip away appeared first on The Decoder.
Trillion-Parameter RL Weight Syncs Drop From 87 Minutes to 150 Seconds
NeMo-DCR: Bit-Exact Delta-Compressed Refit for Scalable Agentic RL at Trillion-Parameter Scale
Authors: Songlin Jiang, Zhiyu Li, Terry Kong, Yu Yao, Youngeun Kwon, Bernard Nguyen, Ashwath Aithal, Mario Di Francesco (NVIDIA)
Abstract
Abstract. Agentic reinforcement learning (RL) disaggregates training from rollout, so each policy update must reach the rollout clusters before the next batch. Transferring a full 1T checkpoint for such weight synchronization (refit) takes 87.5 min between two AWS regions. Measurements of BF16 training show that about 1% of weights change their stored values per step. Recent systems exploit this sparsity but fall short on placement, exactness, or efficiency: they reimplement placement rules, assemble full tensors, rebuild values arithmetically, or use a cross-cluster collective, and none fully recovers from mid-refit failures. We present NeMo-DCR (Delta-Compressed Refit), which sends only changes yet is bit-exact: receivers obtain the same parameter and buffer bits as a dense refit. For placement, fixed affine mappings project changes from training shards into the checkpoint’s canonical coordinates, residual conversion covers the other changes, and the serving runtime’s native loader places all changes in receiver storage. For exactness, compressible XOR masks carry affine changes whose projection and loader preserve stored bits, and overwrites carry the others. Receivers apply both in place, retries overwrite partial writes, and a joint commit binds the policy to the baseline for the next delta. For efficiency, object storage or a relay tree streams payloads during delta construction, without a cross-cluster collective. Even at 3% and 5% change rates, NeMo-DCR refits of 30B–1T models are 12–40× faster than a transport-only full-checkpoint reference. A 1T relay-tree refit at 3% takes 150 s instead of 87.5 min, making refits practical for cross-cluster agentic RL at trillion-parameter scale. Documentation: NeMo RL weight refit guide Code: NeMo RL pull request #2444
1 Introduction
Agentic reinforcement learning (RL) spends over 70% of its wall-clock time in rollout, so rollout is disaggregated from training and runs on serving clusters with suitable hardware and parallel layouts [6, 7]. Before the next rollout batch, a refit must deliver the updated policy to the receivers, the rollout ranks that generate responses with a serving runtime [15]. Disaggregation also lets rollout run on idle serving GPUs [6] or in other datacenters [41, 40], where every refit must cross a wide-area network.
A cross-cluster transfer of a 120B model’s 247.2 GB checkpoint through object storage takes 750 s, and at the 1T scale of models like Kimi K2 [14], such a transfer takes 87.5 min (Figure 1). Yet in the six models of Figure 2, only 0.6–1.2% of training-side source elements change their bfloat16 (BF16) values per step. We call this fraction the element change rate. With only 8 significant bits, BF16 rounds most optimizer updates away. Other reports give element change rates of 1.5–2.0% in Qwen3 RL [26] and average deltas of 1.98% of a 1,024 GiB checkpoint [5]. A full-checkpoint transfer thus spends 98–99% of its bytes on unchanged elements.
Figure 1: NeMo-DCR relay-tree refit at a 3% element change rate versus the transport-only full-checkpoint reference: 22.6 s instead of 750 s at 120B and 150 s instead of 87.5 min at 1T (§§ 8.5 and 8.6).
Figure 2: Element change rate per optimizer step, averaged over each model’s first five steps with the setup of Appendix E: at most 1.2% in every model.
(Footnote: footnotetext: Work conducted during an internship at NVIDIA.)
A refit that sends only the changed 1% faces three challenges: placement, exactness, and efficiency.
First, placement: sparse source changes do not tell receivers where or what to write. A training-shard location does not map directly to a receiver’s storage location: refitting may gather, split, or permute tensors between training and rollout layouts [26]. A change to a shared scale factor can also alter converted values even when other source values stay unchanged [23]. Some systems reimplement the serving runtime’s placement rules [6, 26], and others extract a delta after full-tensor assembly and conversion, which handles both problems but pays for both steps [11].
Second, exactness: a smaller transfer must still deliver the exact updated bits, because rollout–training mismatch is known to destabilize RL [28]. Arithmetic reconstruction can introduce floating-point rounding errors [26], while absolute overwrites avoid rounding [19] but resend unchanged bits within changed values. Failures also threaten exactness: applying updates in place avoids a separate receiver-side baseline copy, but an interrupted refit can leave a mixture of old and updated values that matches neither policy version. Because a delta applies only to the version it was computed from [19], recovery must complete the interrupted refit before rollout resumes and keep receivers aligned with the source baseline that the next refit compares against.
Third, efficiency: delivery must overlap the other refit stages without a cross-cluster collective. The next rollout batch waits for the complete update, so without overlap, delta construction and application can offset the transfer savings. A cross-cluster collective couples receiver membership to the training cluster and introduces timeouts upon failure [22]. Some deployments share weights only through object storage [3], and others have direct links between clusters [40], so delivery must support both.
Existing systems meet these challenges only in part: they either send every weight or lack exactness, native placement, decoupled delivery, or recovery, so none meets all five requirements in Table 1. We present NeMo-DCR, a system for bit-exact delta refit that meets all five: it sends only changes, yet every receiver obtains the same parameter and buffer bits as a dense refit that sends every weight. The key idea is to describe changes in canonical coordinates, the tensor names and indices of the Hugging Face checkpoint format that both training and serving already support. Fixed affine index mappings project changes directly into these coordinates and cover over 96% of the weight bytes in the mixture-of-experts (MoE) checkpoints. The serving runtime’s native loader then maps these coordinates to receiver storage, much as a page table maps virtual to physical addresses.
|
Approach |
Systems |
Bit-exact |
Delta |
Native |
Decoupled |
Recovery |
|---|---|---|---|---|---|---|
|
G1 |
G2 |
G3 |
G4 |
G5 |
||
|
A Dense collective refit |
NCCL-Reshard [22] |
✓ |
– |
(✓) |
– |
(✓) |
|
checkpoint-engine [20] |
✓ |
– |
✓ |
– |
(✓) |
|
|
B Full-checkpoint transfer |
TensorHub [40] |
✓ |
– |
(✓) |
✓ |
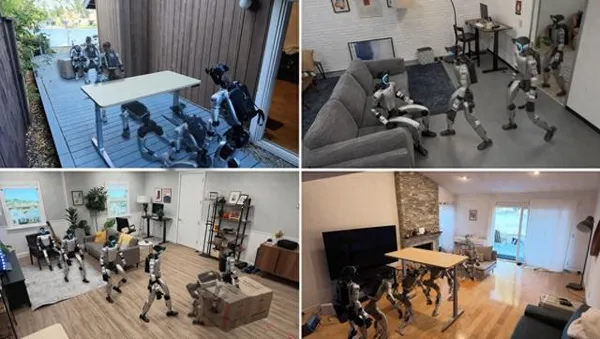
苹果研究团队披露机器人“大脑”进展 调用千问模型在宇树G1上验证
苹果研究团队披露机器人“大脑”研究进展。当地时间11月4日,苹果研究团队在预印本平台arXiv提交论文《Perceptive Humanoid Motion from Simulation》,披露了人形机器人自主控制系统HALO。研究团队将该系统部署在宇树科技的G1人形机器人上进行验证,让机器人将在仿真环境中学到的动作,带到陌生的现实房间中执行。
阅读全文
阿里巴巴发布《2026 AI向善行动报告》 AI数据中心可持续发展成年度亮点

独家丨腾讯20年老兵创业 AI 体感主机,融资超六千万
 创始人刘丹曾任光子工作室群副总经理、《斗战神》制作人。
作者丨陈玘凡
雷峰网·鲸犀独家获悉,AI 体感成长主机公司创想悦动已完成种子轮融资,投资方为创维战投、创维数字,总金额约六千万元。
创想悦动目前已经开启新一轮融资,意在进行更多后续内容开发、东南亚海外市场拓展、线下渠道铺设及下一代产品预研。
创想悦动创始人刘丹曾任光子工作室群副总经理、天行工作室总经理,于 2003 年加入腾讯互娱,参与见证腾讯游戏从起步到壮大的全过程,主导并参与了《QQ堂》、《QQ宠物》《斗战神》等项目。核心团队均来自腾讯、字节、阿里等头部互联网公司。
刘丹告诉雷峰网·鲸犀,“创想悦动当前以及未来在做的事情与索尼、任天堂一样”,既搭建主机硬件平台,也构建应用内容生态。
由于体感内容对于算力、存储的高要求,传统的电视机如果集成对应模块,会导致成本和售价的大幅上涨。而创想悦动选择将体感内容做成主机,通过摄像头结合端侧 AI 实现对用户骨骼、动作、表情识别,将体感运动、体感娱乐、体感学习塞进家庭客厅,和电视配成“互动大屏家庭新生态”。
Youdoo Box 硬件的几个发售版本,售价处于一千多至三千多的价格段,其中游戏与应用内容的基础版永久免费,高级功能通过会员订阅解锁。
创想悦动首款 AI 体感成长主机 Youdoo Box 已于今年 7 月 5 日发布,累计销量破 2 万台。
内容层面,Youdoo Box 已有近 40 款应用,同时已与小马宝莉、小猪佩奇等卡通 IP 签约,明年目标应用数量突破百款。
刘丹认为,现在的孩子作为电子设备原住民,可以操控手机平板等设备,但是却并没有相应的信息分辨能力和自制力。
长时间使用电子设备,不仅不利于孩子世界观塑造,同时也会对视力造成伤害。
因此,团队希望打造一款能够让家长放心、孩子健康玩耍、寓玩于成长的体感设备,为沉迷手机等孩子成长中的家长困扰提供更优的解决方案。
从全球市场看,家庭体感主机赛道已不算是全新赛道,Nex Playground 在 23 年底上市后,一直在海外处于领先地位,并于上月完成超 1.5 亿美元 E 轮融资,估值近 10 亿美元;而中国市场目前仍然处于赛道开拓阶段。
创想悦动产品后续更多进展,雷峰网·鲸犀将持续关注,欢迎添加作者微信 IvarQFC 交流。


申通快递和千问办公达成战略合作,推动物流服务智能化升级
今日消息,申通快递与千问办公正式达成战略合作。双方将围绕快递核心场景打造 AI 办公体系,以Agent能力支撑申通快递全国网点的增长战略落地,推动AI从总部管理向末端网点规模化输出,加速物流服务智能化升级。申通快递总裁韩永彦与千问办公CEO陈宇森等共同见证签约。
图示 申通快递和千问办公战略合作签约现场
申通快递作为中国头部快递企业,拥有覆盖全国的转运、网点及末端派送网络,聚焦快递主业,为超过40个行业提供定制化解决方案,搭建一体化仓配供应链服务体系,网络覆盖广、区域布局纵深、网点多级协同运营,沉淀了深厚的快递场景经验与运营积淀。
面对链路长、协同要求高的物流场景,申通快递对高效率、可落地、安全可控的企业级 AI 生产力工具存在深层次需求。千问办公本次和申通快递合作,将把 Agent 套件能力与申通快递的行业经验深度融合,共同打造快递行业 Agent 规模化落地标杆,沉淀出可供整个物流行业持续复用的数字资产。
此前,千问办公已在申通快递安全管理、人力资源、行政运营等场景率先落地。以安全管理为例,过去员工的安全咨询与预警动态均依赖人工处理;如今依托千问办公,常见安全问题能由Agent自动响应,预警信息每日定时推送。此外,安全团队还借助千问办公搭建管理后台,将事件监控、实时台账与趋势分析汇成统一视图,推动安全管理从“被动响应”转向“主动管理”。这一变化,也与申通快递推动网点运营从“经验驱动”向“数据驱动”转型的方向一致。
未来,申通快递将在全国网点推进千问办公落地,重点提升网点管理与运营效率,并在电商场景共同打造智慧物流,帮助商家增强运营和服务能力,提升消费者购物体验。
据公开资料,千问办公是阿里旗下企业级通用Agent产品,是AI办公赛道增长最快的产品之一,目前行业头部企业均已接入千问办公。

李佳琦卖出万份Token,天猫的AI生意才刚开场
Token正在成为AI时代的“流量包”。(雷峰网雷峰网雷峰网)
11月2日晚,李佳琦直播间上架AI千问办公的Token算力,开播半小时,售出10万份千问办公个人会员月卡,累计约2万亿Token。
这次千问办公CEO陈宇森也来到直播间现场,雷峰网此前了解到,这位阿里最年轻的事业部CEO,业内普遍评价他能力很强,具备出色的产品sense、表达能力和商业认知都超出大部分阿里的资深老员工,“登味”极少。
说起来,阿里在就9月份就已有动作,同期天猫设立“AI空间站”,就有三家厂商入驻:千问、智谱、Minimax,充值规格分为月卡、季卡和年卡三档;阿里旗下的三档AI应用分别也给出了20%—40%的优惠;更早些,智谱直接在天猫开通官方旗舰店。
从模型厂商到电商平台,再到直播间,Token正在被包装成一种可以直接购买的商品。
但对电商平台来说,把Token摆上货架只是第一步。至于做成一门生意,是另一件事。(作者持续关注字节百度等大厂,欢迎添加微信Who123start畅聊)
01
电商平台为什么盯上Token?
不只淘天一家的动作。京东同期上线“AI软件充值馆”,引入智谱GLM、京东云、DeepSeek、腾讯云、火山引擎等产品;早在5月,三大运营商就已将Token套餐引入营业厅。
与此同时,腾讯云将MaaS升级为Token Hub,阿里也在3月成立ATH事业群,6月成立Token Foundry事业部,由集团CEO吴泳铭直接挂帅,延续阿里的“Token战略”。
说到底,电商平台看中的,是Token背后的流量、商家和交易资源。
有接近大厂的人士透露,某互联网公司事业部曾尝试把核心电商平台流量与大模型Token捆绑销售:商家不买Token,就不优先推荐商品。
这个做法在内部引发过争议,有人担心商家会转投其他平台,但决策层认为,这是当时风险最低、见效最快的变现路径。
等到一个月后免费额度用尽,调用量和收入双双下跌,内部才意识到,高用量不等于真实需求。
这套做法未必能代表电商平台的普遍策略,却说明了平台的一种想法:AI可以成为经营商家、提高流量变现效率的新工具。
一位大厂的电商从业者谈到AI时,也提到了商家留存。他认为,AI工具能够提升中小商家留在平台直播间的意愿,说白了就是和其他平台争夺商家。但他也提出一个问题:平台是为了服务好现有商家、避免他们流失,还是靠更好的工具吸引更多商家进场?
对平台,这两件事都意味着新机会。AI工具可以帮助商家提效,Token则可以直接拿来赚钱。
一位从业者半开玩笑地对雷峰网说,卖Token和卖流量包、话费充值差不多。过去,用户要购买模型服务,通常需要进入厂商控制台、注册账号、获取API Key,再按调用量充值。
如今,模型调用资源被包装成月卡、年卡和场景套餐,可以直接放到电商货架上。
这也是Token适合进入电商平台的原因:它有明确的计量单位,也能被包装成不同价位的商品。
02
货架搭起来了,生意还没跑通
不过,Token能卖出去,不代表它能成为一门稳定的生意。
首先是用户能不能留下来。
有网友在李佳琦直播间里,下单千问会员的理由只是标价0.01元:“也不知道是干嘛的,反正便宜就买了。”消费者对Token没有概念,更谈不上忠诚。
从模型厂商的店铺销量看,智谱旗舰店卖得最好的一款套餐成交200多份,MiniMax旗舰店的最好成绩是100多份。

相比直播间的短时销量,这些数字还不足以说明用户会持续购买。后期需要观察的,是首批用户的复购达到多少。
一位云市场的负责人曾用水电来形容Token服务:用户今天用哪家的Token,下一次完全可以换一家。因为模型调用是一种无状态服务,一次调用结束后,用户的数据并不会自然留在模型厂商那里。
其次是商品能不能让消费者看明白。
每百万Token多少钱,看起来是一个简单的比价问题,实际上各家套餐的分词规则、计费口径和质量等级并不相同。
如果用户连自己买到了多少、实际消耗了多少都难以判断,明码标价也很难真正形成有效的商品比较。
最后是平台不能只做一个货架。
如果只负责把用户引到厂商店铺完成交易,那么它更像是销售渠道;如果能持续帮助用户发现、比较和使用不同模型服务,才有机会成为AI服务分发平台。
对电商平台来说,单纯完成上架、支付和交付,未必能形成长期优势。
03

在芬兰卖二手衣服,已经成了一门大生意
(本文作者为 好望角,钛媒体经授权发布)
文 | 好望角
芬兰人在网上买衣服,最常去的网站是Zalando。排第二的,是一家二手平台。
芬兰商业联合会(下称商业联合会)今年6月发布的服装零售研究显示,在芬兰消费者最常用的服装鞋履购物网站里,德国电商Zalando排名第一,立陶宛二手平台Vinted升至第二。
芬兰人的服饰消费预算,正在涌向旧衣市场。
2025年,芬兰居民服装消费约52亿欧元。商业联合会预计,2026年和2027年服装鞋履的实际消费增长都在1%以下。同一时期,芬兰二手商品市场已达约14亿欧元,两年增长56%。这个数字涵盖服装、家具、电子产品等全部品类。
万事达卡经济研究所今年的报告给出了更直接的对比。芬兰消费者在古着、二手和慈善商店的支出,相当于服装店支出的10.5%,在报告覆盖的市场里排在前列。在全球20个主要循环消费市场,2025年二手服装销售额增长28%,服装店只增长8%。
一个几乎不增长的服装市场里,二手成了长得最快的市场。平台、专业转售商、物流公司和服装品牌,都在这门生意里找到了位置。中国的跨境快时尚,则成了它最大的对手。
一、芬兰人买旧衣服,环保不是首要因素
去年9月,商业联合会的调查显示,66%的芬兰人在过去一年买过二手商品,30岁以下人群的比例是81%。芬兰邮政Posti的千人调查发现,有二手购物经历的人里,约三分之一每月至少买一次。服装是最受欢迎的品类,41%的受访者把它列为有吸引力的二手商品,比电子产品和家具都高。
说起北欧人买二手,人们容易想到环保。Posti调查里的排序却是另一回事:74%的人把便宜列为购买理由,提到可持续发展的占49%,喜欢淘便宜货的占38%,想买独特款式的占34%,找停产商品的占26%。
省钱排在环保前面,和芬兰人这几年的钱包有关。商业联合会的服装零售研究把当地服装市场的压力归为四条:购买力恢复缓慢、国际低价竞争、人口老龄化,以及二手交易本身的扩张。
四条里分量最重的是就业。芬兰失业率已经连续两年上升,今年9月为10.5%,是欧盟最高。年轻人更难,今年7月芬兰25岁以下人群的失业率为23.4%。最常买二手衣服的30岁以下芬兰人,恰好是收入最不稳定的一群人。
老龄化的作用主要落在需求端。年纪越大,买新衣服越少,服装店最倚重的顾客群在人口中的比重随之下降。服装零售因此更依赖年轻人,而年轻人恰恰是二手平台和低价电商最主要的顾客。
国际低价竞争和二手交易扩张,则从两个方向压低衣服的价格。前者让新衣服更便宜,后者让旧衣服更容易买到。芬兰本土的服装零售商,同时被这两股力量往下拉。
二手衣服还有一层新衣服没有的好处:它能再卖。一件状态好的品牌外套,穿一季再挂到网上,还能收回一部分钱。消费者买衣服时,开始顺手估算这件衣服将来值多少。
越多人这样买衣服,二手市场的货源就越多。今天的买家,明天就是卖家。
二、一门已经成形的生意
芬兰本土有老牌二手平台Tori。Vinted进入芬兰后扩张很快,不到两年就成了最受欢迎的二手平台之一,在55岁以下女性中尤其受欢迎。
Vinted的生意是一种轻模式。它不采购,不囤货,货架上的每一件衣服都来自用户的衣柜。平台管搜索、支付、物流和纠纷,主要向买家收取商品价格3%到8%的买家保护费,外加一笔固定费用。
2025年,Vinted平台交易额108亿欧元,增长47%;收入11亿欧元,增长38%。公司最新估值80亿欧元,业务覆盖26个国家,今年初进入美国。净利润6200万欧元,比上一年少19%,钱花在了开拓德国、扩充品类、自建快递和钱包上。
Vinted今年的影响力报告给出两个数字:平台上时尚商品的平均成交价比同类新品的原始零售价低72%;88%的买家买新品之前,会先上Vinted看一看。后一个数字的分量更重,二手平台正在变成年轻人买衣服的第一站。
围绕Vinted,一条产业链已经长出来。商业联合会的研究显示,消费者之间的线上交易约占芬兰循环商品市场的62%;企业直接卖二手商品的业务约占四分之一,两年翻了一倍多,本土的Emmy、Ninyes、Relove等公司分别在做线上转售、精选二手和线下门店。
Posti披露,2025年初它处理的电商包裹里,约四分之一装的是二手商品。Marimekko、Nanso、Luhta都推出了自己的转售服务,Zalando从2020年起经营二手时尚,今年又上线了二手童装。
三、最大的对手,是更便宜的新衣服
二手生意在芬兰长大的这几年,中国跨境电商也在芬兰长大。
商业联合会的网购研究显示,2025年芬兰人网购总额约56亿欧元,每十欧元就有一欧元流向中国网店,Temu已升至芬兰第七大网店。比价网站Hintaopas的调查显示,18到24岁的芬兰人里,63%在Temu或Shein上买过东西。
这和二手衣服的主力买家,几乎是同一群人。商业联合会发现,接近70%的二手服装买家也买快时尚,接近五分之一的二手服装买家买过从没穿过的衣服。
于韦斯屈莱大学去年的一项访谈研究观察到,受访的年轻女性常常在没有明确需要时买二手衣服,衣柜满了再挂回平台。
一个失业率居欧盟之首的国家,一群收入最不稳定的年轻人,手里只有一份买衣服的预算。Vinted和Shein抢的,就是这一份钱。
表面上看,这是一场价格战。二手衣服要经过卖家拍照上架、买家挑选、快递寄送,才能到消费者手里。一件全新T恤的价格如果已经逼近二手T恤,二手交易的吸引力就弱了。
更深一层的冲突,发生在货源上。
二手平台没有自己的工厂,它的货架是过去几年新衣服的销量堆出来的。按第三方卖家数据统计,Vinted上挂单最多的品牌是Zara和H&M。大众快时尚做得好,二手平台的货就多;这些衣服质量尚可、有品牌认知,穿过一两年还能卖出几欧元到二十几欧元。
超低价快时尚改变了这条供应链。一件穿几次就变形的衣服,几乎没有转卖价值,挂上平台也卖不掉,最后涌进回收箱和慈善商店,抬高分拣和处理成本。商业联合会去年发布研究时,标题直接发问:低价进口是否也在威胁二手市场。
换句话说,Shein今天卖出去的衣服,就是Vinted三年后的货架。超低价衣服卖得越多,二手平台未来能卖的好货就越少。二手生意靠中档快时尚喂养长大,最大的威胁来自比中档快时尚更便宜的那一批。
四、Shein和Vinted,正在长成对方的样子
两家公司对标国内的话,大概是这样的:淘宝卖出去的东西,很多最后流到了闲鱼上。一件商品的第一次出售和之后的转手,都在阿里一家的体系里完成,用户、支付和物流都是打通的。
欧洲没有这样一家公司。第一次出售在Shein、Zara、Zalando手里,第二次转手在Vinted手里。Shein做二手平台,Zalando卖二手童装,Vinted自建快递和钱包、往电子产品和家居扩张,都是在往自己缺的那一半补。欧洲服装电商接下来的竞争,要看谁先拼出一个自己的"淘宝加闲鱼"。
两家公司都不背传统意义上的库存。Shein靠小单快返,先少量生产,卖得好再追单,把压货的风险降到最低。Vinted更彻底,它连货都不碰,库存放在用户的衣柜里。
区别在供给。Shein的供给是有弹性的,工厂随时可以多做;Vinted的供给是固定的,取决于过去几年人们买过什么。
价格上,旧衣服有一个任何工厂都没有的优势:边际成本接近零。一件穿过的衣服,对卖家来说早已付过钱,不卖就只能丢掉或捐掉,所以几欧元也愿意出手。
Shein的价格再低,也要覆盖面料、加工和运费,现在还要加上3欧元关税。单比价格,最便宜的新衣服也很难长期便宜过旧衣服。
Shein的优势在别处:确定性。想要什么款式、什么尺码、什么颜色,下单就有,全新,几天送到。
二手衣服的短处恰恰在这里:每一件都不一样,尺码不全,要花时间找,到手的东西和照片可能有出入。价格接近的时候,消费者会为确定性买单。
于是两家公司补短板的方向,正好朝着对方。
Vinted在补确定性。它扩充电子产品、家居、运动用品等品类,自建快递Vinted Go,上线钱包,在欧洲铺了50多万个取寄件点。按财报算,Vinted的收入约为平台交易额的10%,客单价越低,每一单能分到的钱越少。公司把压缩成本说成让低价商品也能成交的关键。几欧元一单能不能赚钱,决定了它能不能接住越来越便宜的衣服。
Shein在补残值。2022年10月,它推出二手交易平台Shein Exchange,用户可以在Shein的App里转卖买过的Shein衣服;2024年这个平台从法国开始引入欧洲,在美国,它2023年吸引了420万用户。自家衣服能转卖,消费者下单新衣服时就多了一个理由,人也留在了Shein的App里。
政策加快了这种靠拢。今年7月1日起,欧盟取消150欧元以下小包裹的关税豁免,改为每个商品类别征收3欧元固定关税。这项关税只针对从欧盟以外寄来的包裹,Vinted上的交易发生在欧盟内部,不受影响。
法国一家追踪150万人银行流水的公司观察到,6月到7月,Temu的交易量下降50%,AliExpress下降37%,Shein只下降15%。
一个合理的解释是Shein的本地仓走得最早:它在波兰弗罗茨瓦夫建了大型仓储中心,今年又宣布在法国BHV百货再开五家门店。Temu也定下目标,让欧洲80%的销售从本地仓库发货。
芬兰这边,Hintaopas此前的调查显示,在欧盟以外网店购物的芬兰人里,有一半表示取消免税后很可能少买。
本地仓能绕开小包裹关税,代价是要提前把货放进欧洲。从中国工厂直接发小包裹,是Shein效率最核心的来源;把货压进欧洲仓库,意味着它要开始承担一部分传统零售商的库存风险。关税正在把Shein推向一家本地零售商的样子。
五、被挤出去的,是夹在中间的品牌
这场竞争里最难受的,是既不够便宜、也不够保值的服装品牌。足够便宜的衣服有Shein和Temu,有品牌、耐穿的衣服有二手市场接盘,夹在中间的衣服两头都靠不上。
芬兰上市的服装零售集团Lindex Group,旗下有Lindex连锁店和Stockmann百货。
它的年报显示,Stockmann在芬兰和波罗的海国家面对的时尚、美妆和家居市场,2024年萎缩1.5%,2025年又萎缩0.6%。集团2025年收入9.52亿欧元,按本币计算与上年持平,利润的改善主要来自去年8月结束的重组和成本压缩。中端零售商还能活下来,靠的是效率,需求没有回来。
更小的本土品牌已经撑不住。旗下拥有服装品牌Makia、家纺品牌Finlayson和Vallila的设计集团Manna & Co,去年4月在重组失败后申请破产。
接下来,压力会落到另一个环节:卖不掉的衣服由谁来处理。
芬兰在这件事上走得比欧盟更早。2023年1月起,芬兰强制推行废旧纺织品分类回收,比欧盟的统一要求早了两年,目前覆盖了97%到98%的人口。芬兰每年废弃的纺织品大约有7万到10万吨,而位于派米奥的处理厂每年只能处理约1.2万吨,约占全国的十分之一。
回收点收上来的衣服里,还常常混着完好能穿的,这部分会被转到回收公司自营的商店或慈善跳蚤市场,回收体系本身也成了一条二手渠道。
欧盟的新规则会把处理成本推回给生产者。修订后的《废弃物框架指令》去年10月生效,各成员国要在2028年前后建立纺织品生产者责任制度。
所有在欧盟销售衣服的企业,包括欧盟以外的企业和电商平台,都要为衣服的回收、分拣和再利用付费。
收费会按耐用性等指标浮动,指令还要求成员国在定费时考虑快时尚和超快时尚的做法。
过去,一件卖不出去、也转卖不掉的便宜衣服,最后由慈善机构和市政回收系统兜底。新规则之下,这部分成本会被写回衣服的价格里。3欧元关税和生产者责任,一个管衣服怎么进来,一个管衣服最后去哪,都在抬高超低价新衣服的价格下限。
二手增长的环保效果,目前还很难下定论。Vinted称平台上76%的购买替代了一次新品购买,但没有说明如何计入衣服的折旧;于韦斯屈莱大学的访谈研究则显示,一部分二手消费发生在新衣服之外。
芬兰约14亿欧元的二手商品市场,和Vinted在芬兰服装网购中的第二名,说明二手已经是一门大生意。
它能长到这么大,靠的是新衣服对芬兰年轻人来说太贵;它还能长多大,要看新衣服会便宜到什么程度。欧盟正在做的,是给新衣服的价格设一个底。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App
宇树跟红杉都不想自己“努力”了?
(本文作者为 硅碳变量,钛媒体经授权发布)
文|硅碳变量,作者|沈浪
10月末,宇树科技联合红杉中国宣布,共同成立“杉宇·创计划”。专注发掘与投资具身智能、机器人应用及其上下游关键技术、其他前沿硬科技等领域的早期创业项目。
在硬科技成为全球资本确定性主线的当下,科技企业下场做VC早已不是新鲜事。
不完全统计显示,智元、星海图、自变量、银河通用、逐际动力、DeepSeek、智平方先后布局产业投资,甚至智元也曾与高瓴资本联手。通过资本绑定上下游、卡位技术路线,几乎已成头部玩家的标准操作。
但宇树这一动作如果要结合新发布的第三季度财报来看,则显得意味深长。
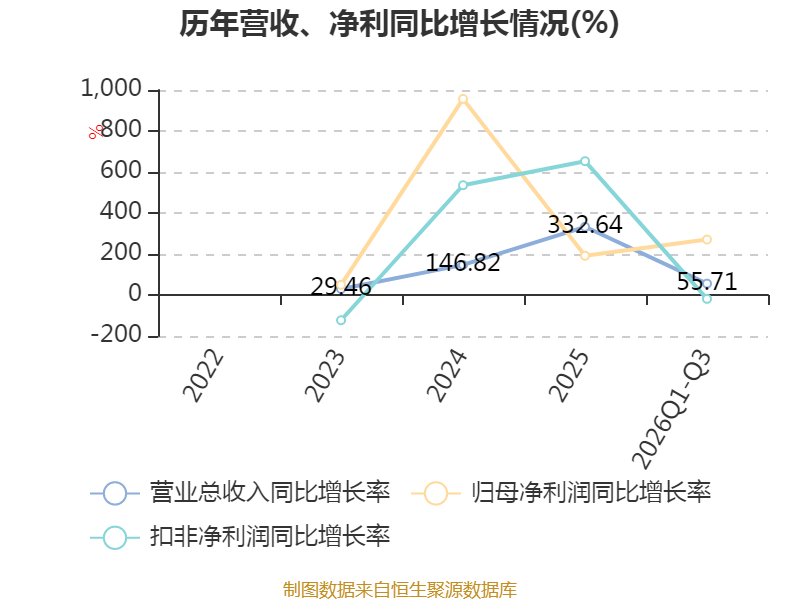
数据显示,宇树Q3营收6.65亿元,同比增长69.93%;归母净利润1.13亿元,同比下降17.37%;扣非净利润1.05亿元,同比下降17.42%。
营收与利润出现背离的原因,是成本投入在爆发式增长。前三季度的研发投入达到2.63亿元,同比增长191.48%。其中,第三季度单季研发投入1.27亿元,同比增长249.58%,占当季营收的19.10%。
销售费用也从上年同期7600.85万元增至约2.30亿元。对于宇树而言,未来的压力或许会越来越大,单靠自己“死磕”已经不现实,企业必须拉上顶级资本寻找新的盟友,把接下来的一部分成本与风险分摊出去。
是第二曲线,还是带头“抱团”?
事实上,宇树的营收增速在2026年以后就开始逐渐放缓。
数据显示,2023到2025年,宇树科技营收额分别1.59亿元、3.93亿元、16.99亿元,三年营业收入的复合增长率达226.78%。而2026年前三季度,宇树累计营收为18.17亿元,增速放缓至55.71%。
更重要的是,宇树至今的盈利模式十分单一,主要靠机器人硬件销售。宇树的招股书显示,企业的主要收入来自硬件销售,其中,人形机器人、四足机器人和机器人组件的销售占据了宇树高达98.64%的收入。

然而,随着消费端“降温”,往后这一模式能否经受得起冲击还未可知。当前,曾撑起机器人销售“半壁江山”的租赁行业正在加速坍塌,据悉,宇树机器人G1基础款的日租金已降至2000元以下,而机器狗的租金已跌至500元以下。
从宇树这边来看,其存货价值的确在上升。
三季报显示,截至2026年9月30日,宇树的存货价值达10.19亿元,而2025年12月31日这一数据是3.67亿元。尽管这与销售端未必有直接的因果关系,但增至2亿的销售费用,似乎印证着机器人真的不好卖了。
当前,宇树急需寻找业务第二曲线,投资或许是个不错的选择。
在宇树之前,智元就曾通过投资给主业降本提效,同时又赚足了生态布局的估值红利。根据智元官方信息,过去一年半的时间里,智元共投了超过20家企业,被投企业平均年化估值增长了17倍。
在全球科技创新一度停摆、互联网与消费赛道投资回报收缩后,具身智能一跃成为造富效应最惊人的风口赛道之一。以宇树自己为例,上市时宇树科技有超40名股东,早期的投资者获得数百倍回报。
这一造富神话点燃了一级市场的寻宝热情,资本四处搜寻下一个“宇树”。
而宇树当然也想成为蛋糕的分食者之一。
同时,具身智能产业链条庞杂冗长:上游覆盖电机、传感器、芯片,中游包含算法、运动控制系统,下游分散在工业、商用、家用。对宇树而言,与其大包大揽,不如借助投资把压力输送给外部创业者。
这也是科技厂商投资的主要目的。例如,智元早在2024年就推出“创投A计划”,2024年8月至2026年10月,智元作为投资方出现在47起投融资事件中,多数集中在智元整机上游关键节点上。
无独有偶,星海图联合凯辉基金发布“星途计划”,要5年合计投入10亿元,投100家具身智能早期项目,覆盖零部件、数据、算法、场景应用……毕竟全栈自研的试错成本太高、风险太大,这才是效率最高的玩法。
但这是否也意味着具身智能赛道正式进入了头部带头“抱团”时代?
不得不承认,行业的两极分化正加速拉开,即便是站在金字塔尖的玩家,也难言稳定盈利。
例如,优必选2025年归母净利润亏损7.03亿元,2026年上半年归母净亏损3.11亿元;乐聚机器人2025年归母净利润亏损6977.94万元,较前两年亏损额放大;云深处2025年归母净利润2868.4万元,但2026年上半年转为亏损,归母净利润亏损达880.63万元。
巨头之间的资本绑定,进一步放大了这种分化效应。原本2025年168家获投具身智能企业中,前十家公司就获得了134.72亿元融资,占该统计口径全年融资总额的40.95%。到2026年,具身智能赛道在资本端的地位开始下降。
未来,订单、资本将向着少数具备产业协同价值的上游节点快速汇集,拿到头部产业方下注的创业公司,能拿到源源不断的资源。而没有进入这套抱团网络的中小团队,很容易被边缘化,慢慢失去试错机会。
即便,这本身也是巨头的无奈之举。
论「杉宇系」的形成困难
在与红杉合作之前,宇树就发布了“宇创计划”,面向机器人行业创业团队。据王兴兴在“2026年世界物理AI大会”上表示,宇创计划一个多月就收到了超过200个项目,未来五年希望孵化200家以上优质企业。
时至今日,这一计划升级,或许具身智能赛道将要诞生一个「杉宇系」。
在此之前,整个具身智能划分流派基本根据创业者的经历背景,例如,IT桔子发布的《中国具身智能创业者生态画像报告》,主要分为华为、微软、百度、谷歌、大疆、阿里、腾讯、字节、小米共9大流派。
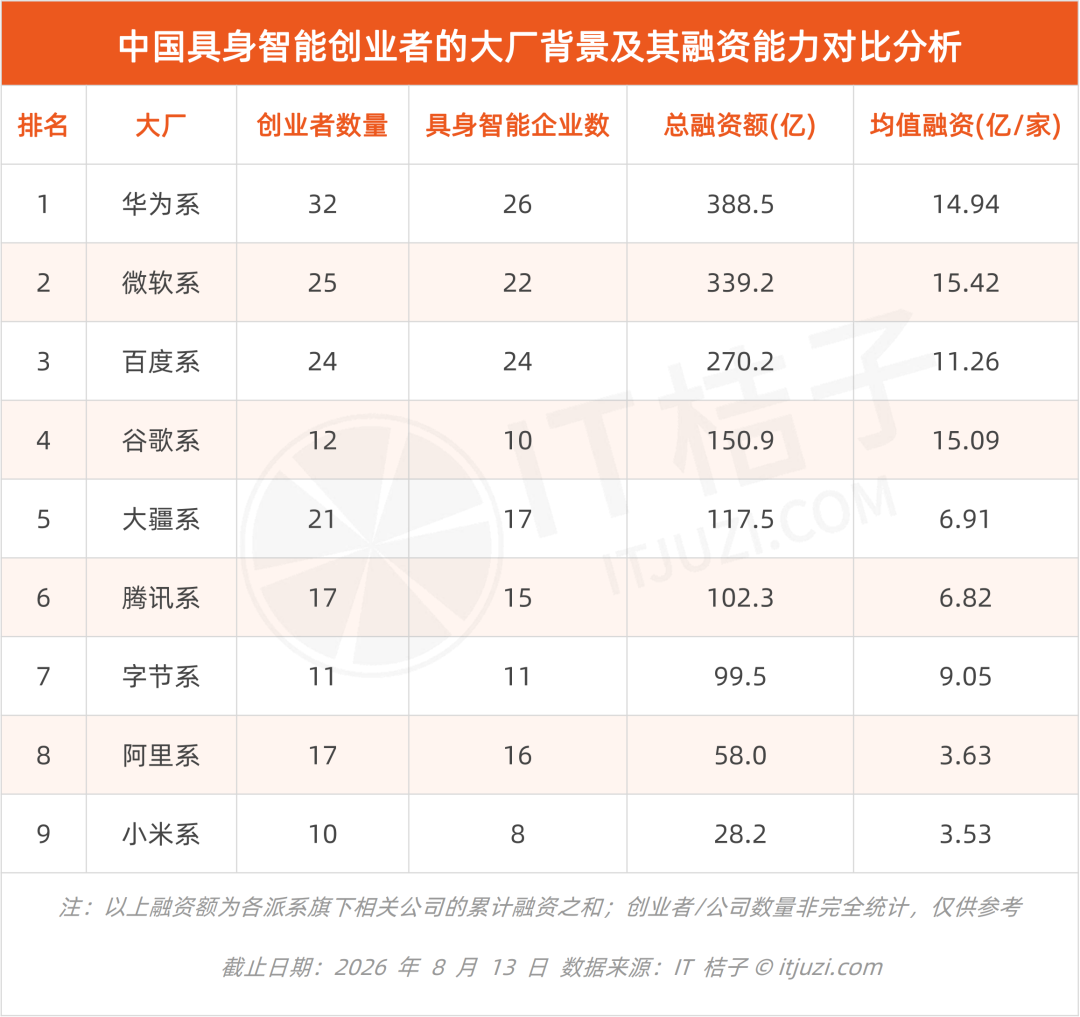
据悉,华为系是具身智能赛道上融资总量最高的派系,截止2026年8月13日,26家企业合计融资388.5亿元。这种基于一家创业公司的创始人、核心团队来自哪家大厂,就归入哪个派系的流派划分方式,其实背后看的是人才溢出、校友网络、技术习惯。
但宇树与红杉或许会开启一个产业流派,以头部整机或具身大模型厂商为枢纽,联合资本设立专项产投计划,孵化上下游项目,绑定订单、测试平台……除了杉宇系,国内具身智能赛道还有智元系、星途系。
目前,智元系已经有了明星选手,2026年2月,智元参与辉羲智能超8亿元的Pre-B轮融资,据披露,辉羲上半年出货量约占全球高算力机器人芯片同期出货量的五分之一,仅次于英伟达,居全球第二。
杉宇系尚在起步阶段,谁能成为这个新派系里的新星,眼下还没有标准答案。
但可以确实的一点是,具身智能赛道里优质项目正在快速枯竭,好标的越来越少。
资本热度的退潮,最先暴露了项目供给的萎缩。IT桔子统计显示,2026年10月具身智能赛道发生33起融资、总额101.05亿元,而9月是60起、110.28亿元,交易数量近乎腰斩;对比6月热度顶峰时的55起、308.92亿元,落差更为明显。
据悉,一级市场新钱收紧,二级市场老股交易也出现估值崩塌。
根据“腾讯科技”报道,8月之前一些头部机器人公司的老股大约九折就能找到买家,而最近,部分交易中甚至出现了5折报价。根据《证券时报》,近两个月,部分具身智能公司的老股转让报价集中在上一轮估值的6.5折至8折,出售标的包括头部企业。
估值倒挂的背后,是赛道已经进入批量出清周期。近两年来,包括智橙动力、深兰机器人、达闼机器人、龙慧医疗、锥能机器人等一大批机器人公司相继破产,其中不乏产业龙头孵化、知名投资机构及行业大佬加持的明星项目。
当一大批腰部项目接连倒下,留给宇树、红杉的选择自然越来越少。
此前行业狂热期,大批人才从大厂出走创业,随便拿出一套样机就能拿到天使投资。如今资本告别了曾经的 PPT 叙事,创业门槛被陡然拉高,硬核团队已经变得稀缺。这也给杉宇系埋下了第一道难关。
新的派系竞赛里,万万没想到出现了“巧妇难为无米之炊”的尴尬。
AI时代,VC越来越依赖产业方?
一个令人好奇的问题:红杉作为头部资本,为什么不单独下注具身智能赛道,而要拉上宇树?
进入2026年,红杉对AI赛道的重视更进一步。截至2026年8月6日,红杉资本已完成规模约100亿美元的新一轮募资,据报道,这笔“弹药”将主要押注人工智能,标志着这家老牌风投正式迈入以AI为核心的新阶段。
而具身智能一级市场也彻底热闹起来,美元基金、人民币创投、国家级科创基金、产业战略投资……参与者络绎不绝。但传统财务VC在新一轮硬科技周期里显然失去了一贯的从容。
以移动互联网时代为例,财务VC的判断逻辑基本只要看团队、看模式、看用户增长,数据可以快速验证,扩张可以依靠烧钱完成,往往一个 Demo、一份增长曲线,就足以支撑投委会决策。
但到了硬科技时代则不一样,尤其当下的具身智能赛道各类创业项目良莠不齐。就连红杉这类顶尖机构对于优质项目都是可遇不可求。2025年到2026年,红杉在同一家具身智能企业“无界动力”身上前后参投了四次。
据悉,红杉拉上宇树是想搭建一套“工程师+投资人”的双轨决策机制。在这套分工里,宇树负责工程侧的判断,红杉守住资本侧的能力。同时,宇树负责提高技术、场景,红杉负责提供资金。
然而,这是否也意味着传统财务VC在AI时代会进一步加大对产业方的依赖?
事实上,今年5月份,“证券时报”就指出,在上一代制造业、移动互联网,乃至当下仍火热的芯片半导体赛道中,CVC的优势都未曾被放大。但在AI与机器人赛道,带着场景、需求和工程师团队的,只有企业创业投资(CVC)能做到。
相比财务VC,CVC在投资过程中最大的“王牌”是订单和场景,对传统财务VC而言,几乎是降维打击。根据“烯牛数据”发布的报告,当前AI、具身智能领域的头部创业公司背后,几乎都站着不同类型的产业资本,市场上主流的CVC基本是“人手”3家以上头部项目。
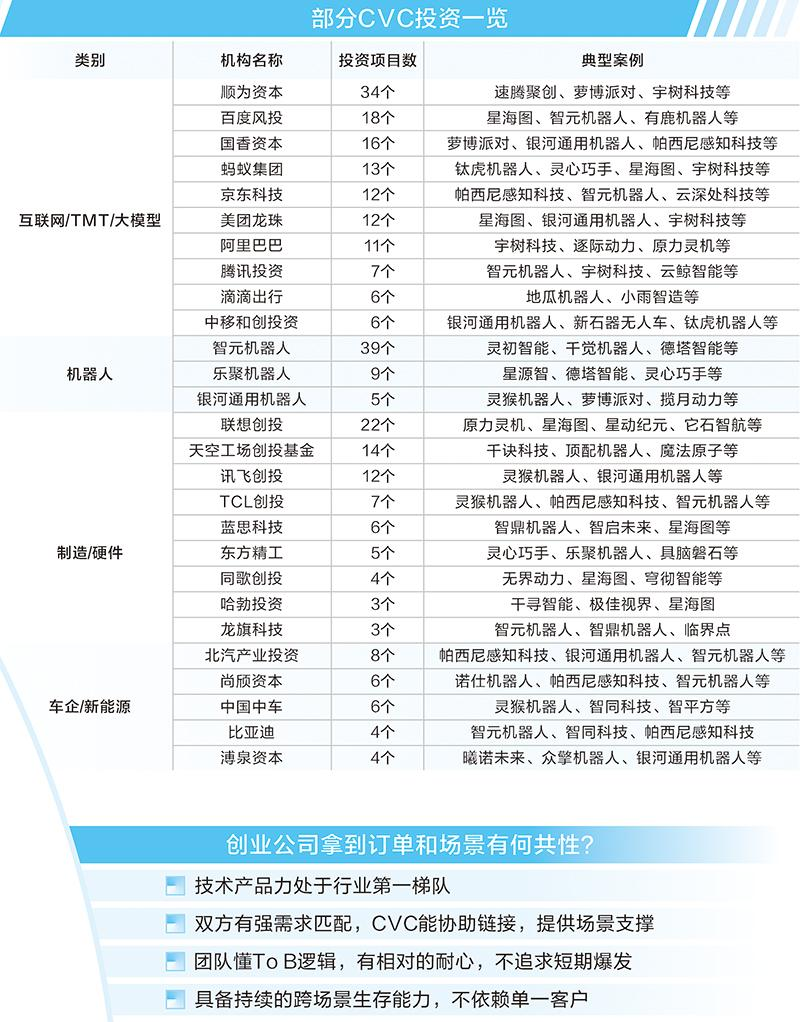
目前,互联网大厂、硬件制造巨头、车企、头部机器人企业已经悉数入场。这个队伍还在继续扩大,证券时报记者梳理,今年以来,长鑫科技、兆易创新、长电科技等多家顶流科技公司都先后下场布局一级市场投资,成为市场上新一波新贵LP(有限合伙)。
而越来越多的硬核科技企业入局,会从募资、项目、定价等多个方面来挤压红杉这类传统财务 VC,毕竟如果优质项目更看重产业资源、场景落地,那么估值逻辑就会被重写,VC投资自主权也会跟着收缩。
当前已经有不少财务VC感受到,由于CVC的早早入局,一定程度上抬高了市场估值的水位。“证券时报”就报道过一个例子,去年八九月份,一家头部机器人企业投后估值不过25亿元,仅仅过去半年,估值翻了4倍多。
财务VC主动牵手宇树这类产业方,是想以联合体模式补齐短板,重塑自身竞争力。
手握百亿美元弹药的红杉,终究没能独自蹚过具身智能的深水区。牵手宇树,更像一场体面的退让,老牌风投放下了身段,一个时代的投资逻辑正在谢幕。从此以后,决定赛道话语权的,不再是谁手里的钱更厚。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App

The TechBeat: Shipaton Blogging Contest Winners Announced 🎉 (11/6/2026)
How are you, hacker?
🪐Want to know what's trending right now?:
The Techbeat by HackerNoon has got you covered with fresh content from our trending stories of the day! Set email preference here.
## I Compared 8 AI Agent Platforms. Here's What Running a Team Actually Costs
By @thomascherickal [ 55 Min read ]
Compare 8 AI coding platforms, explore 10 multi-agent workflows, and learn how local LLMs can eliminate API token fees. Read More.
Proof of Usefulness Hackathon Final Winners Announced 🎉 
By @proofofusefulness [ 5 Min read ] The Proof of Usefulness Hackathon announces its final winners, awarding $118,000 in cash prizes and software credits across five categories. Read More.
Shipaton Blogging Contest Winners Announced 🎉 
By @hackernooncontests [ 4 Min read ] Meet the 10 finalists and three winners of HackerNoon's $2,500 Shipaton 2026 Writing Contest, celebrating the stories behind new apps. Read More.
Why Knowledge Graphs and Ontologies Are Making a Comeback in the Age of AI 
By @linked_do [ 21 Min read ] Context runs the spectrum of semantics, state, and controls. Read More.
**[GPT 6 Astra - Will It Shake
Up the World of Marketing?](https://hackernoon.com/gpt-6-astra-will-it-shake-up-the-world-of-marketing)**  By @vlabroo [ 3 Min read ]
The launch of GPT 6 Astra by open AI promises to forever alter the way marketing has been approached and carried out hitherto. Read More.
Theo de Raadt: The Man Who Built the Internet's Locks 
By @zbruceli [ 13 Min read ] Theo de Raadt built OpenSSH and OpenBSD for a world he didn't trust. It cost him NetBSD, a DARPA grant and many friends. The world moved in anyway. Read More.
What The Heck Is Jev 
By @progrockrec [ 4 Min read ] Jev is an AI model that decides instead of writing. See how a decision model could tag data in OpenMetadata, and why open-weights Laya fits the job. Read More.
10 Billion-Dollar Startup Ideas Generated by Gemini 4 Argon 
By @thomascherickal [ 20 Min read ] I asked Gemini 4 Argon for 10 Billion-Dollar Products that I could build with it. It Blew My Mind, the products are insane and solve huge problems! Read More.
Spec-Driven Development: Let the Specification Drive the Code 
By @renanb [ 5 Min read ] Learn Spec-Driven Development: treat specifications as the source of truth, review AI-generated code, and stay in control of your software. Read More.
Qwen3.8-27B Defiance: An Uncensored AI Model With 40 Modes 
By @aimodels44 [ 10 Min read ] Learn how Qwen3.8-27B Defiance works, including its uncensored weights, custom AI personas, GPU requirements, performance, and limitations. Read More.
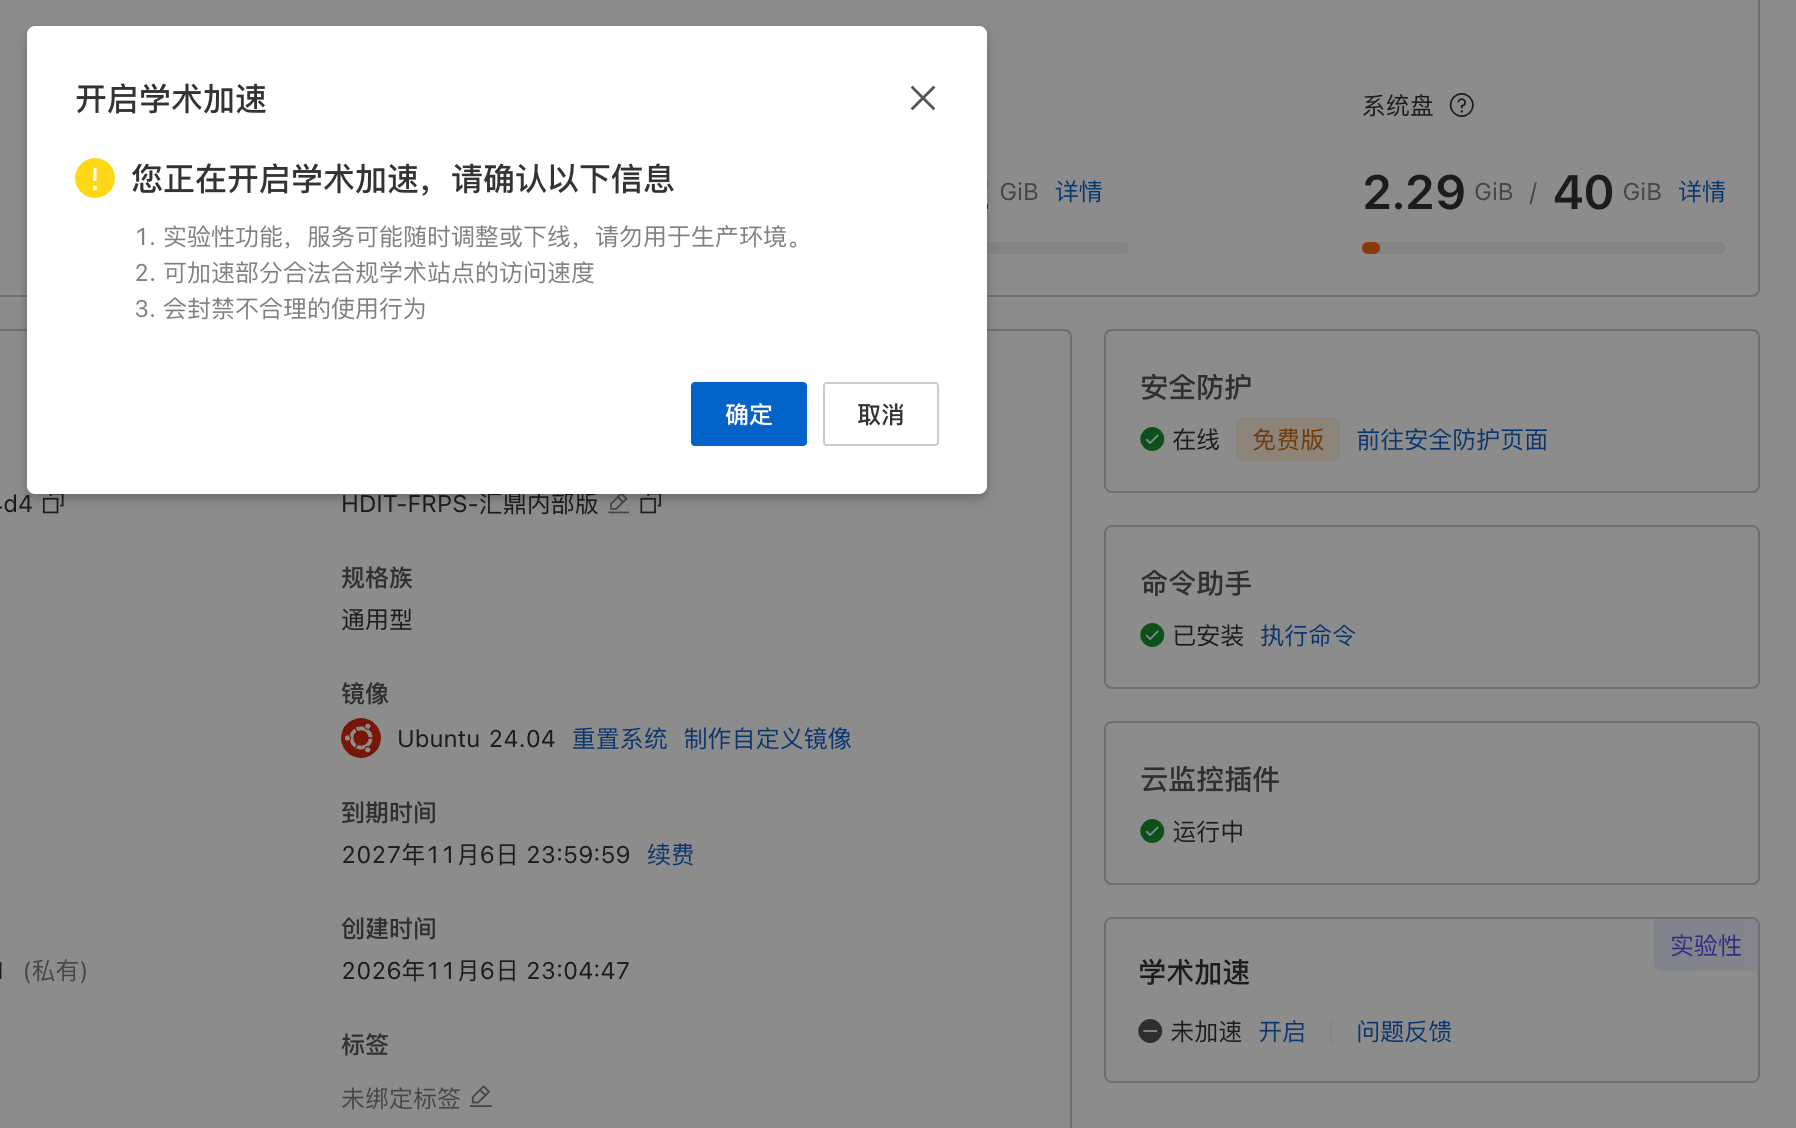
[问与答] 阿里云国内的轻量云 上线了“学术加速” 按钮
开启会提示还是内测功能,然后继续开启就会出现报错。
有的时候很困扰,阿里云如果关闭了 22 端口还会出现安全提醒。
内测的功能直接放在主页上。
咋想的

我为什么不太看好苹果国行AI
(本文作者为 互联网怪盗团,钛媒体经授权发布)
文 | 互联网怪盗团
千呼万唤始出来,苹果国行AI (Apple Intelligence)终于于11月4日凌晨向中国大陆用户开放了开发者Beta测试,预计于12月随着iOS 27.3正式版全面推出。基座大模型将采用苹果本地模型+阿里千问的方式,这一点也早已被双方的公告证实。
我是一个忠实的苹果用户。我无法想象把自己的手机从iOS生态换成安卓生态。但是,这并不意味着我就要看好苹果国行AI。准确地说,我不看好苹果AI在全世界的前景,尤其不看好在中国大陆的前景——如果事实证明我错了,我会很高兴的。
我不太看好苹果国行AI的理由主要有三条:
苹果AI难以全面适配国内的移动APP生态;
iOS第一方应用在国内的使用率不足,难以发挥苹果AI的优势;
本地模型+第三方的模式的效率还需要进一步观察。
先说第一条。其实就算在美国,苹果AI对第三方APP的适配程度也不够,目前适配程度比较深的第三方APP包括WhatsApp, Audible, Microsoft Outlook, 等等——其中只有WhatsApp是货真价实的头部APP。谷歌、亚马逊旗下的应用,以及Meta旗下的其他应用,与苹果AI的结合程度参差不齐,而且它们从来没有承诺过任何支持。
在中国就更是如此了。考虑到苹果与千问的合作关系,我们可以期待,或许阿里系APP会比较开放。可是腾讯系、字节系、以及其他大厂呢?别的不说,字节跳动是非常想做软硬件一体化的,豆包手机没有流行起来,不是它不想,而是条件还不成熟。以字节跳动管理层的风格,我很难想象字节系APP向苹果AI敞开胸怀、深度结合。
中国的移动互联网,本来就是一个大厂彼此封闭、山头林立的生态。这个问题不但困扰着苹果,也困扰着国产安卓厂商。从十几年前开始,无数硬件厂商幻想过“硬件即入口”,“通过智能设备抓住用户”,结果几乎全部被互联网大厂击破。在这个过程中,苹果是自主权相对较高的,但绝不是完全自主。它只能通过高度集中的监督体系,促使第三方APP符合自己的规则,却不可能让它们事事服从自己的命令。
假设打不开第三方APP的生态,那么苹果AI的主战场就变成了iOS第一方应用。悲催的地方就在这儿:国内的iPhone普及率很高,但Mac普及率不足,结果导致整个苹果第一方应用的使用率都不足。别误会,我不是说国内没有人用Mac,只是说Mac在国内、尤其是在生产力领域的普及率赶不上美国等发达国家。(这句话本来可以不加的,但我知道不加的话肯定会有杠精拿来做文章,这就是我现在越来越愿意跟AI打交道,而不是跟真人打交道的原因!)
Pages, Numbers, Keynote...这些苹果第一方办公应用,在国内的用户基数远远落后于微软Office和金山WPS. 苹果备忘录功能在国内几乎没什么人使用。(注:我知道有人用,我自己就用,只是用的人少,所以为了防杠精,我还是得加上这个括号。这再次证明我是个人写作而不是AI写作!)Facetime在国内的生态位几乎完全被微信视频聊天占领。我相信在苹果国行AI开放初期,使用率最高的功能是修改照片,因为苹果相册还是人人都用的。
苹果的智能翻译是一个非常强大的功能,与信息、电话、Facetime和AirPods深度结合。不过有个大问题,现阶段只能通过AirPods进行翻译,而持有AirPods的用户毕竟是少数。第二个大问题是,这种智能翻译显然不适合于微信语音、腾讯会议、飞书和钉钉的语音会议,而国内大部分语音对话其实是在这些场景举行的。我们当然也可以期待这些大厂良心发现,全面接入苹果AI的翻译功能,但公允地说,还不如期待外星人明天降临并解决地球上的一切问题。
我们也可以把其他APP当中的内容复制粘贴到苹果第一方应用当中,例如把WPS里的文本粘贴到Pages里面,让苹果AI去分析总结。问题在于,为什么要这么做呢?在这种场景里,苹果AI与豆包、DeepSeek、千问APP相比,又有什么优势呢?老实说,还不如微信AI,因为大部分中国用户每天使用微信的时长肯定超过使用苹果第一方应用。(注:我闻到了杠精的气息,他们正打算在我的评论区出没,但我是不会把他们的抬杠言论放出来的。)
至于苹果本地模型+第三方大模型,这个模式倒是苹果AI一贯的,只是国内的供应商换成了千问。说实话,这个模式的问题一直不小,复杂需求跳转到第三方APP内部完成,对用户体验是很大的损害。两三年前,我们还可以期待苹果模型有一天成长起来、足够强大、完成全部任务;现在大家都看清了,苹果不太可能成为大模型的第一梯队,因为第一梯队已经过于拥挤了。
苹果模型在国内通过了审核,这是一件好事,也是苹果国行AI上线的先决条件。然而,本地模型+第三方大模型的问题一直在那里,没有消失;国行还增加了一个跨国协作的问题。对于这个问题,我想说的还有很多,但考虑到篇幅问题,在此就不展开了。
PS: 苹果国行AI的图片搜索功能会连接到百度识图,这说明百度并没有在苹果AI生态当中出局。不过它究竟会扮演什么角色呢?具体到图片搜索,今后苹果还会不会给国行用户提供更多选择?这些问题,恐怕都要等到12月全面推送时才能解决。
iOS生态在中国的成功,其实是“一半优势发挥、另一半优势没发挥”的结果:
发挥了的那一半,是iOS对第三方APP权限的严格管理,对用户数据的保护,以及硬件标准化带来的良好适配机制。只要拥有iPhone就能享受到这些优势,而iPhone在苹果中国区收入的占比,一直要高于在苹果美国区收入的占比。
没发挥的那一半,是iOS第一方应用,以及与Mac的结合。必须承认,国内过去、现在和可见的未来,都是Windows PC的天下,我自己就一直使用Windows,无法享受强大的苹果整合生态。每年都有少量用户投奔Mac,但是这么多年过去了,积累的总量还远远不够。
苹果AI若要发挥全部作用,恰恰要依赖那另一半优势。因此我没有理由看好它——需要依赖一个尚不存在的优势才能发挥作用,那么它的作用多半发挥不出来。
这并不代表我不看好苹果手机在中国的未来。iPhone 16系列和17 Pro系列刚刚在大中华区创造了销量纪录,就算苹果国行AI彻底打了哑炮,应该也不会对iOS生态的市场份额造成太大影响。几乎不会有iOS用户因为苹果AI不好用就换成安卓——如果他们真的在意,过去两年早就会这么做的。
更多精彩内容,关注钛媒体微信号(ID:taimeiti),或者下载钛媒体App